3.5 Análise de Performance para Atributos
A capacidade para dados atributivos é simplesmente definida como a proporção média ou a taxa de não conformidade do produto (AIAG, 1995) visto que, os gráficos de variáveis referem-se a variação ($6\widehat{\sigma}_{R/d_2}$) inerente produzida pelo processo estável.
5.1 - Análise de performance para dados binomiais
Dados com distribuição binomial estão associados com o número registrado de itens defeituosos em relação ao total de itens presentes na amostra.
-
O resultado de cada item avaliado deve ser obtido nas mesmas condições de avaliação dos demais itens.
-
Os resultados dos itens são independentes.
-
O resultado da avaliação de cada item é classificado em sucesso ou fracasso.
A proporção média é dada por
$$\overline{p} = \dfrac{D_{Tot}}{N_{Tot}}$$
em que
$D_{Tot}$ = Soma das quantidades de itens defeituosos em cada amostra.
$N_{Tot}$ = Quantidade de itens avaliados.
A porcentagem (%) de defeituosos é dada por
$$\char37 \hbox{Defeituosos} = \overline{p}\ast 100$$
Intervalo de confiança para porcentagem de defeituosos
Os limites inferior e superior (LI e LS) são dados por
$$LI = \dfrac{\nu_{1} \ast F_{\left(\frac{\alpha}{2},~\nu_{1},~\nu_{2}\right)}}{\nu_2 +\nu_1 \ast F_{\left(\frac{\alpha}{2},~\nu_{1},~\nu_{2}\right)}}$$
$$LS = \dfrac{\nu_{3} \ast F_{\left(1-\frac{\alpha}{2},~\nu_{3},~\nu_{4}\right)}}{\nu_4 +\nu_3 \ast F_{\left(1-\frac{\alpha}{2},~\nu_{3},~\nu_{4}\right)}}$$
$$\char37~\hbox{Defeituosos} ~LI = LI \ast 100$$
em que
-
$\nu_1 = 2 \ast D_{Tot}$
-
$\nu_2 = 2 \ast (N_{Tot} - D_{Tot} + 1)$
-
$\nu_3 = 2 \ast (D_{Tot} + 1)$
-
$\nu_4 = 2 \ast (N_{Tot} - D_{Tot})$
-
$F_{\left(\frac{\alpha}{2},~\nu_1,~\nu_2\right)}$ = quantil da distribuição F com $\nu_1$ e $\nu_2$ graus de liberdade e que deixa uma área de $\alpha/2$ à esquerda.
-
$F_{\left(1 - \frac{\alpha}{2},~\nu_3,~\nu_4\right)}$ = quantil da distribuição F com $\nu_3$ e $\nu_4$ graus de liberdade e que deixa uma área de $1 - \alpha/2$ à esquerda.
Intervalo de confiança para PPM
PPM: É o número esperado de peças defeituosas em um milhão de peças produzidas.
$$\hbox{Limite inferior} = 1.000.000 \ast (LI)$$
$$\hbox{Limite superior} = 1.000.000 \ast (LS)$$
Índice de capacidade (Z)
Quanto maior o valor do índice de capacidade (Z) melhor é a performance do processo.
$$\hbox{Processo Z} = -1 \ast \phi^{-1}(\overline{p})$$
em que
$\phi^{-1}(\overline{p})$: quantil da distribuição normal padrão (0,1) com área acumulada igual a $\overline{p}$. Essa função pode ser calculada diretamente pelo Software Action.
Intervalo de confiança para o índice de capacidade (Z)
$$\hbox{Limite inferior} = -1 \ast \phi^{-1}(LI)$$
$$\hbox{Limite superior} = -1 \ast \phi^{-1}(LS)$$
Exemplo 5.1.1
Uma indústria está interessada em analisar a capacidade do processo no qual verifica-se a proporção de peças defeituosas em lotes de 1000 peças. Os dados estão na Tabela 3.5.1.
| Amostra | Peças defeituosas | Total de peças na amostra |
|---|---|---|
| 1 | 432 | 1000 |
| 2 | 392 | 1000 |
| 3 | 497 | 1000 |
| 4 | 459 | 1000 |
| 5 | 433 | 1000 |
| 6 | 424 | 1000 |
| 7 | 470 | 1000 |
| 8 | 455 | 1000 |
| 9 | 427 | 1000 |
| 10 | 424 | 1000 |
| 11 | 410 | 1000 |
| 12 | 386 | 1000 |
| 13 | 496 | 1000 |
| 14 | 424 | 1000 |
| 15 | 425 | 1000 |
| 16 | 428 | 1000 |
| 17 | 392 | 1000 |
| 18 | 460 | 1000 |
| 19 | 425 | 1000 |
| 20 | 405 | 1000 |
| TOTAL | 8664 | 20000 |
Tabela 3.5.1: Dados de lotes de peças.
$$\overline{p} = \dfrac{D_{Tot}}{N_{Tot}} = \dfrac{8664}{20000} = 0,4332$$
$$\char37 \hbox{Peças defeituosas} = 43,32.$$
Intervalo de confiança para % peças defeituosas
Calculando os valores de $\nu$ e F temos
$$\nu_1 = 2 \ast D_{Tot} = 2 \ast (8664) = 17328$$
$$\nu_2 = 2 \ast (N_{Tot} - D_{Tot} + 1) = 2 \ast (20000 - 8664 + 1) = 22674$$
$$\nu_3 = 2 \ast (D_{Tot} + 1) = 2 \ast (8664 + 1) = 17330$$
$$\nu_4 = 2 \ast (N_{Tot} - D_{Tot}) = 2 \ast (20000 - 8664) = 22672$$
$$F_{\left(\frac{\alpha}{2},~\nu_1,~\nu_2\right)} = 0,9723927$$
$$F_{\left(1-\frac{\alpha}{2},~\nu_3,~\nu_4\right)} = 1,028336$$
Com isso, os limites são dados por
$$\hbox{Limite inferior}~(LI) = \dfrac{\nu_{1} \ast F_{\left(\frac{\alpha}{2},~\nu_{1},~\nu_{2}\right)}}{\nu_2 + \nu_1 \ast F_{\left(\frac{\alpha}{2},~\nu_{1},~\nu_{2}\right)}}$$
isto é,
$$LI = \dfrac{17328 \ast 0,972}{22674 + (17328 \ast 0,972)} = \dfrac{16842,82}{22674 + 16842,82} = 0,426219$$
$$\char37~LI ~ \hbox{para peças defeituosas} = LI \ast 100 = 0,426219 \ast 100 = 42,6219$$
Já para o limite superior temos
$$\hbox{Limite superior}~(LS) = \dfrac{\nu_{3} \ast F_{\left(1-\frac{\alpha}{2},~\nu_{3},~\nu_{4}\right)}}{\nu_4 +\nu_3 \ast F_{\left(1-\frac{\alpha}{2},~\nu_{3},~\nu_{4}\right)}}$$
$$LS = \dfrac{17330 \ast 1,028336}{22672 + (17330 \ast 1,028336)} = \dfrac{17821,06}{22672 + 17821,06} = 0,440102$$
$$\char37~LS~\hbox{para peças defeituosas} = LS \ast 100 = 0,440102 \ast 100 = 44,0102$$
Intervalo de confiança para PPM
$$PPM = \overline{p} \ast 1.000.000 = 0,4332 \ast 1.000.000 = 433200$$
$$\hbox{Limite inferior} = 1.000.000 \ast LI = 1.000.000 \ast 0,426219 = 426219$$
$$\hbox{Limite superior} = 1.000.000 \ast LS = 1.000.000 \ast 0,440102 = 440102$$
Índice de capacidade (Z)
$$\hbox{Processo Z} = -1 \ast \phi^{-1}(\overline{p}) = -1 \ast \phi^{-1}(0,4332) = 0,168233$$
sendo
$$\phi^{-1}(\overline{p}) = -0,168233$$
Intervalo de confiança para índice de capacidade (Z)
$$\hbox{Limite superior} = -1 \ast \phi^{-1}(0,440102) = 0,1507114$$
$$\hbox{Limite inferior} = -1 \ast \phi^{-1}(0,426219) = 0,1857569$$
A seguir temos os resultados obtidos pelo Software Action para esse exemplo.
| Porcentagem de Defeitos: | |
|---|---|
| Alvo % (Opcional) | 0 |
| Porcentagem de Defeitos: | 43.32 |
| Limite Inferior: | 42.631773 |
| Limite Superior: | 44.01017 |
Tabela 3.5.2: Porcentagem de Defeitos
| Taxa de Defeitos | |
|---|---|
| Taxa de Defeitos: | 0.4332 |
| Limite Inferior: | 0.426318 |
| Limite Superior: | 0.440102 |
Tabela 3.5.3: Taxa de Defeitos
| ICP | |
|---|---|
| ICP | 0.168233 |
| Limite Inferior: | 0.185757 |
| Limite Superior: | 0.150711 |
Tabela 3.5.4: ICP

Figura 3.5.1: Gráficos da análise de performance do processo.
5.2 - Análise de performance para dados Poisson
Dados com distribuição Poisson estão associados com o número de não-conformidades observados num certo item (amostra) ao longo do espaço/tempo.
-
A taxa de não-conformidades por unidade (tempo, medida, etc.) é a mesma para qualquer item.
-
O número de não-conformidades observados em um item é independente de qualquer outro.
A média de não-conformidades por item é dado pela fração
$$\overline{\hbox{Def}} = \dfrac{D_{Tot}}{N}$$
em que
$D_{Tot}$ = Soma de todas as não-conformidades
N = Quantidade de amostras.
Intervalo de confiança para $\overline{\hbox{Def}}$ com 95% de confiança
Os limites são dados por
$$\hbox{Limite inferior}~(LI) = 0,5 \ast \dfrac{1}{N_{Tot}} \ast \chi^2_{\left(\frac{\alpha}{2},~\nu_{1}\right)}$$
$$\hbox{Limite superior}~(LS) = 0,5 \ast \dfrac{1}{N_{Tot}} \ast \chi^2_{\left(1 - \frac{\alpha}{2},~\nu_{2}\right)}$$
em que
-
$\nu_{1} = 2 \ast D_{Tot}$
-
$\nu_{2} = 2 \ast (D_{Tot} + 1)$
-
$\chi^2_{\left(\frac{\alpha}{2},~\nu_{1}\right)}$ = quantil da distribuição qui-quadrado com $\nu_{1}$ graus de liberdade e que deixa uma área de $\alpha/2$ á esquerda.
-
$\chi^2_{\left(1 - \frac{\alpha}{2},~\nu_{2}\right)}$ = quantil da distribuição qui-quadrado com $\nu_{2}$ graus de liberdade e que deixa uma área de $1 - \alpha/2$ à esquerda.
A média de não-conformidades por unidade de medida dentre todas as amostras é dada por
$$\overline{DPU} = \dfrac{D_{Tot}}{N_{Tot}}$$
em que
$D_{Tot}$ = Soma de todas as não-conformidades
$N_{Tot}$ = Soma de todos os tamanhos de amostra.
Intervalo de confiança para $\overline{DPU}$ com 95% de confiança
Os limites são dados por
$$\hbox{Limite inferior}~(LI) = 0,5 \ast \dfrac{1}{N} \ast \chi^2_{\left(\frac{\alpha}{2},~\nu_{1}\right)}$$
$$\hbox{Limite superior}~(LS) = 0,5 \ast \dfrac{1}{N} \ast \chi^2_{\left(1 - \frac{\alpha}{2},~\nu_{2}\right)}$$
em que
-
$\nu_{1} = 2 \ast D_{Tot}$
-
$\nu_{2} = 2 \ast (D_{Tot} + 1)$
-
$\chi^2_{\left(\frac{\alpha}{2},~\nu_{1}\right)}$ = quantil da distribuição qui-quadrado com $\nu_{1}$ graus de liberdade e que deixa uma área de $\alpha/2$ à esquerda.
-
$\chi^2_{\left(1 - \frac{\alpha}{2},~\nu_{2}\right)}$ = quantil da distribuição qui-quadrado com $\nu_{2}$ graus de liberdade e que deixa uma área de $1 - \alpha/2$ à esquerda.
Ainda,
$\min\lbrace DPU \rbrace$: é o menor valor de DPU entre todas as amostras.
$\max\lbrace DPU \rbrace$: é o maior valor de DPU entre todas as amostras.
Exemplo 5.2.1
Uma indústria está interessada em analisar a capacidade do processo no qual verifica-se o número de pontos não-conformes numa lâmina de aço, sendo que cada lâmina mede 50 $cm^2$. Os dados estão dispostos na Tabela 3.5.5.
| Amostra | Nº de Não-conformidade | Tamanho da Amostra ($cm^2$) |
|---|---|---|
| 1 | 2 | 50 |
| 2 | 4 | 50 |
| 3 | 3 | 50 |
| 4 | 1 | 50 |
| 5 | 2 | 50 |
| 6 | 5 | 50 |
| 7 | 2 | 50 |
| 8 | 5 | 50 |
| 9 | 4 | 50 |
| 10 | 1 | 50 |
| 11 | 6 | 50 |
| 12 | 3 | 50 |
| 13 | 3 | 50 |
| 14 | 6 | 50 |
| 15 | 1 | 50 |
| 16 | 4 | 50 |
| 17 | 1 | 50 |
| 18 | 8 | 50 |
| 19 | 1 | 50 |
| 20 | 4 | 50 |
| 21 | 4 | 50 |
| 22 | 2 | 50 |
| 23 | 4 | 50 |
| 24 | 2 | 50 |
| 25 | 1 | 50 |
| 26 | 2 | 50 |
| 27 | 2 | 50 |
| 28 | 3 | 50 |
| 29 | 4 | 50 |
| 30 | 4 | 50 |
| Total | 94 | 1500 |
Tabela 3.5.5: Defeituosos em uma lâmina de aço.
$$\overline{\hbox{Def}} = \dfrac{D_{Tot}}{N} = \dfrac{94}{30} = 3,13333$$
Intervalo de confiança para $\overline{\hbox{Def}}$ com 95% de confiança
Calculando $\nu_1$ e $\nu_2$ obtemos
$$\nu_1 = 2 \ast D_{Tot} = 2 \ast 94 = 188$$
$$\nu_2 = 2 \ast (D_{Tot} + 1) = 2 \ast 95 = 190$$
Com isso, os limites serão
$$LI = 0,5 \ast \dfrac{1}{N_{Tot}} \ast \chi^2_{(0,025,~\nu_{1})} = 0,5 \ast \dfrac{1}{30} \ast 151,9231 = 2,532052$$
$$LS = 0,5 \ast \dfrac{1}{N_{Tot}} \ast \chi^2_{(0,975,~\nu_{2})} = 0,5 \ast \dfrac{1}{30} \ast 230,0644 = 3,834407$$
$$\overline{DPU} = \dfrac{D_{Tot}}{N_{Tot}} = \dfrac{94}{1500} = 0,0627$$
Intervalo de confiança para $\overline{DPU}$ com 95% de confiança
$$LI = 0,5 \ast \dfrac{1}{N_{Tot}} \ast \chi^2_{(0,025,~\nu_{1})} = 0,5 \ast \dfrac{1}{1500} \ast 151,9231 = 0,05064103$$
$$LS = 0,5 \ast \dfrac{1}{N_{Tot}} \ast \chi^2_{(0,975,~\nu_{2})} = 0,5 \ast \dfrac{1}{1500} \ast 230,0644 = 0,07668813$$
em que
-
$\nu_{1} = 2 \ast D_{Tot} = 2 \ast 94 = 188$
-
$\nu_{2} = 2 \ast (D_{Tot} + 1) = 2 \ast 95 = 190$
Ainda,
$$\min \lbrace DPU \rbrace = 0,02~~~~~{e}~~~~~\max \lbrace DPU \rbrace = 0,16.$$
A seguir temos os resultados obtidos pelo Software Action para esse exemplo.
| Média de Defeitos | |
|---|---|
| Alvo % (Opcional) | 0 |
| Média de Defeitos: | 3.133333 |
| Limite Inferior: | 2.532052 |
| Limite Superior: | 3.834406 |
Tabela 3.5.6: Média de Defeitos
| Média DPU | |
|---|---|
| Média DPU: | 0.062667 |
| Limite Inferior: | 0.050641 |
| Limite Superior: | 0.076688 |
| Mínimo: | 0.02 |
| Máximo: | 0.16 |
Tabela 3.5.7: Média DPU
| Intervalos de Confiança (PPM) | |
|---|---|
| Média PPM: | 60743.492984 |
| Limite Inferior: | 49380.161529 |
| Limite Superior: | 73821.343308 |
Tabela 3.5.8: Intervalos de Confiança (PPM)

Figura 3.5.2: Gráficos da análise de performance do processo.
Limites de Especificação
Os limites de especificação são os valores que definem a faixa aceitável de um produto ou serviço, estabelecidos com base nas exigências do cliente. Eles são definidos por requisitos específicos e podem incluir limites superiores ($LSE$) e/ou inferiores ($LIE$). É necessário então, calcular a probabilidade de estar fora dos limites de especificação de acordo com a distribuição dos dados, a probabilidade de falha.
$$\text{Prob. de falha} = \text{Prob}[\text{Medida} < LIE] + \text{Prob}[\text{Medida} > LSE]$$
em que:
- $LIE$: Limite inferior de especificação
- $LSE$: Limite superior de especificação
Geralmente, dados associados a contagem de defeitos, é de interesse calcular a probabilidade de estar acima do limite superior de especificação ($LSE$) fornecido pelo cliente.
Probabilidade de falha e PPM
É recomendada a utilização da métrica Partes por Milhão (PPM) para quantificar o risco residual de falha no processo de limpeza. Essa abordagem traduz a probabilidade estatística de falha em uma métrica prática e compreensível, pois permite estimar a quantidade teórica de amostras que poderiam falhar a cada um milhão de execuções do processo.
O PPM esperado correspondente a valores fora do limite de especificação é dado por:
$$(\text{PPM}_\text{esp} > LSE) = 10^6 \times \text{Prob}[\text{Medida} > \text{LSE}]$$
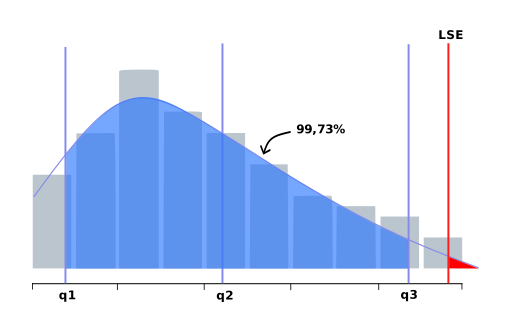
Figura 3.5.3: Visualização de dados e quantis (Área vermelha representa área superior do $LSE$).
Cálculo do Índice Ppk
O índice Ppk mede o desempenho real do processo em relação aos limites de especificação. A taxa total de não-conformidade é convertido em uma escala de distribuição normal padronizada.
O cálculo do Ppk pode ser expresso por:
$$\text{Ppk} = \frac{\Phi^{-1}(1 - (P_{LIE}+P_{LSE}))}{3}$$
em que:
- $P_{LIE}$: probabilidade de falha abaixo do limite inferior de especificação;
- $P_{LSE}$: probabilidade de falha acima do limite superior de especificação.
Os limites geralmente adotados para avaliação da capacidade do processo são:
- Ppk ≥ 1,67: processo altamente capaz;
- 1,33 ≤ Ppk < 1,67: processo capaz;
- 1,00 ≤ Ppk < 1,33: processo moderadamente capaz;
- Ppk < 1,00: processo incapaz, requer ações corretivas.
5.3 - Análise de performance para dados Poisson inflacionada de zeros
Dados com distribuição poisson inflacionada de zeros estão associados com o número de não conformidades observados num certo item (amostra) ao longo do espaço/tempo, nos quais há um excesso de contagens iguais a zero.
-
A taxa de não-conformidades por unidade ($\lambda$) (tempo, medida, etc.) é a mesma para qualquer item.
-
A probabilidade de inflação de zeros ($\pi$) é a mesma para qualquer item.
-
O número de não-conformidades observados em um item é independente de qualquer outro.
O modelo ZIP (Poisson Inflacionada de Zeros) é uma extensão da distribuição de Poisson e corrige o problema do excesso de zeros adicionando um novo parâmetro π. Com isso, esse novo modelo assume dois parâmetros:
-
π: é a probabilidade de inflação, em outras palavras, a proporção de zeros extras no modelo;
-
λ: é a taxa média de ocorrência de defeitos, ou seja, o número esperado de defeitos considerando as situações em que o processo está sujeito à ocorrência de defeitos.
Os parâmetros π e λ podem ser estimados pelo método da máxima verossimilhança. Por fim, a função de densidade de probabilidade da distribuição de Poisson Inflacionada de Zeros é dada por: $$P(Y = y) = \frac{(1-\pi)(e^{-\pi} \lambda^y)}{y!}, \quad (y = 1,2,…)$$
A média de não-conformidades por item é dado pela fração
$$\overline{\hbox{Def}} = (1 - \hat{\pi}) \times (\hat{\lambda})$$
em que
$D_{Tot}$ = Soma de todas as não-conformidades
N = Quantidade de amostras.
Com o(s) limite(s) de especificação definido(s), geralmente o limite superior de especificação $LSE$, é possível calcular os índices de PPM e Ppk referente à probabilidade de falha.
A probabilidade de falha acima do limite superior de especificação é dado por: $$\text{Prob de falha} = \text{Prob}[\text{Medida} > LSE]$$
O PPM esperado correspondente a valores fora dos limites de especificação é dado por:
$$(\text{PPM}_\text{esp} > LSE) = 10^6 \times \text{Prob}[\text{Medida} > \text{LSE}]$$
O cálculo do Ppk pode ser expresso por:
$$\text{Ppk} = \frac{\Phi^{-1}(1 - (P_{LIE}+P_{LSE}))}{3}$$
Exemplo 5.3.1
Uma indústria está interessada em analisar a capacidade do processo no qual verifica-se o número de pontos não-conformes (contagem de bactérias). O limite superior de especificação é $LSE = 10$. Os dados estão dispostos na Tabela 3.5.9.
| Bacteria | Tamanho Amostra |
|---|---|
| 0 | 1 |
| 1 | 1 |
| 0 | 1 |
| 0 | 1 |
| 7 | 1 |
| 0 | 1 |
| 0 | 1 |
| 2 | 1 |
| 3 | 1 |
| 0 | 1 |
| 0 | 1 |
| 0 | 1 |
| 0 | 1 |
| 0 | 1 |
| 1 | 1 |
| 3 | 1 |
| 0 | 1 |
| 4 | 1 |
| 0 | 1 |
| 1 | 1 |
| 0 | 1 |
| 0 | 1 |
| 5 | 1 |
| 0 | 1 |
| 0 | 1 |
| 0 | 1 |
| 0 | 1 |
| 0 | 1 |
| 2 | 1 |
| 0 | 1 |
Tabela 3.5.9: Contagem de bactérias por amostra
Considera-se a distribuição Poisson Inflacionada de zeros pelo excesso de contagens nulas que há nos dados.
A estimação dos parâmetros é dada por: $$\hat{\lambda} = 2,706335 \qquad \text{e} \qquad \hat{\pi} = 0,6428133$$
Média de não-conformidades:
$$\overline{\hbox{Def}} = (1 - \hat{\pi}) \times (\hat{\lambda}) = 0,9667$$
A probabilidade de falha acima do limite superior de especificação: $$\text{Prob de falha} = \text{Prob}[\text{Medida} > LSE] = 0,000691521$$
O PPM esperado correspondente a valores fora dos limites de especificação é dado por:
$$(\text{PPM}_\text{esp} > LSE) = 10^6 \times \text{Prob}[\text{Medida} > \text{LSE}] = 691,521$$
O cálculo do Ppk pode ser expresso por:
$$\text{Ppk} = \frac{\Phi^{-1}(1 - P_{LSE})}{3} = \frac{3,1982}{3} = 1,0661$$
5.4 - Análise de performance para dados Geométricos
Dados com distribuição Geométrica estão associados com o número de tempo (por exemplo dias) até que ocorra a primeira não-conformidade. Assim, deseja-se que resulte a maior quantidade de tempo possível. Essa distribuição é fortemente assimétrica à direita.
-
A probabilidade de ocorrência de uma não conformidade ($p$) por unidade de tempo é constante ao longo do processo.
-
Os intervalos de tempo até a ocorrência de uma não conformidade são independentes entre si.
A média de tempo até a ocorrência de uma não conformidade é dado pela fração
$$\overline{\hbox{T}} = \dfrac{T_{Tot}}{N}$$
em que
$T_{Tot}$ = Soma de todo o tempo acumulado até as não conformidades.
$N$ = Número total de amostras
Com o(s) limite(s) de especificação definido(s), geralmente o limite superior de especificação $LSE$, é possível calcular os índices de PPM e Ppk referente à probabilidade de falha.
A probabilidade de falha acima do limite superior de especificação é dado por: $$\text{Prob de falha} = \text{Prob}[\text{Medida} > LSE]$$
O PPM esperado correspondente a valores fora dos limites de especificação é dado por:
$$(\text{PPM}_\text{esp} > LSE) = 10^6 \times \text{Prob}[\text{Medida} > \text{LSE}]$$
O cálculo do Ppk pode ser expresso por:
$$\text{Ppk} = \frac{\Phi^{-1}(1 - (P_{LIE}+P_{LSE}))}{3}$$
Exemplo 5.2.1
Uma indústria está interessada em analisar a capacidade do processo no qual verifica-se o número de dias até a primeira não-conformidade. O limite superior de especificação é $LSE = 100$.
| Início | Fim | Dias | Tamanho Amostra |
|---|---|---|---|
| 3-Jan | 18-Jan | 15 | 1 |
| 20-Jan | 25-Mar | 64 | 1 |
| 27-Mar | 17-Apr | 21 | 1 |
| 18-Apr | 21-May | 33 | 1 |
| 22-May | 30-Jun | 39 | 1 |
| 1-Jul | 4-Jul | 3 | 1 |
| 5-Jul | 12-Oct | 99 | 1 |
| 13-Oct | 18-Dec | 66 | 1 |
| 19-Dec | 31-Jan | 43 | 1 |
| 1-Feb | 1-Feb | 0 | 1 |
| 2-Feb | 27-May | 114 | 1 |
| 28-May | 8-Jun | 11 | 1 |
| 9-Jun | 14-Jun | 5 | 1 |
| 15-Jun | 5-Aug | 51 | 1 |
| 6-Aug | 25-Aug | 19 | 1 |
| 26-Aug | 27-Aug | 1 | 1 |
| 28-Aug | 2-Sep | 5 | 1 |
| Total | 589 | 17 |
Tabela 3.5.10: Tempo em dias até a não conformidade.
$$\overline{\hbox{T}} = \dfrac{T_{Tot}}{N} = \dfrac{589}{17} = 34,6471$$
A probabilidade de falha acima do limite superior de especificação: $$\text{Prob de falha} = \text{Prob}[\text{Medida} > LSE] = 0,0564819566$$
O PPM esperado correspondente a valores fora dos limites de especificação é dado por:
$$(\text{PPM}_\text{esp} > LSE) = 10^6 \times \text{Prob}[\text{Medida} > \text{LSE}] = 56481,9566$$
O cálculo do Ppk pode ser expresso por:
$$\text{Ppk} = \frac{\Phi^{-1}(1 - P_{LSE})}{3} = \frac{1,585}{3} = 0,52834$$
Figura 3.5.2: Gráficos da análise de performance do processo.
5.5 - Análise de performance para dados Empíricos
Dados com abordagem empírica estão associados a situações em que o analista não assume nenhuma distribuição teórica a priori (como Binomial, Poisson ou Geométrica) para modelar as não conformidades. Essa escolha é indicada quando o processo apresenta comportamento complexo, misturas de populações ou forte instabilidade, baseando-se a análise puramente no histórico de dados coletados.
-
A taxa de não conformidades é avaliada de forma direta sobre os dados observados, sem a pressuposição de parâmetros ideais de uma curva teórica.
-
As inferências e os limites de variabilidade do processo são estimados a partir da própria distribuição empírica da amostra.
A mediana de não conformidades por item ou subgrupo é mais priorizada que a média por ela ser uma medida sensível a valores extremos.
Com o(s) limite(s) de especificação definido(s), geralmente o limite superior de especificação $LSE$, é possível calcular os índices de PPM e Ppk referente à probabilidade de falha.
A probabilidade de falha acima do limite superior de especificação é dado por: $$\text{Prob de falha} = \frac{#[\text{Medida} > LSE]}{N}$$
em que:
-
$#[\text{Medida} > LSE]$ é a quantidade de dados/medidas acima de $LSE$;
-
$N$ é o número total de amostras
O PPM esperado correspondente a valores fora dos limites de especificação é dado por:
$$(\text{PPM}_\text{esp} > LSE) = 10^6 \times \text{Prob de falha}$$
O cálculo do Ppk pode ser expresso por:
$$\text{Ppk} = \frac{\Phi^{-1}(1 - (P_{LIE}+P_{LSE}))}{3}$$
Exemplo 5.5.1
Uma indústria está interessada em analisar a capacidade do processo no qual verifica-se a contagem de não-conformidades em um processo. O limite superior de especificação é $LSE = 100$. Não será assumido nenhuma distribuição.
| Contagem | Amostra |
|---|---|
| 5 | 1 |
| 27 | 1 |
| 31 | 1 |
| 1 | 1 |
| 0 | 1 |
| 15 | 1 |
| 22 | 1 |
| 45 | 1 |
| 23 | 1 |
| 6 | 1 |
| 5 | 1 |
| 105 | 1 |
| 9 | 1 |
| 6 | 1 |
| 1 | 1 |
| 8 | 1 |
| 81 | 1 |
| 9 | 1 |
| 7 | 1 |
| 4 | 1 |
Tabela 5.9.11: Contagem de dados
$$\text{Mediana} = 8,5$$
A probabilidade de falha acima do limite superior de especificação: $$\text{Prob de falha} = \frac{#[\text{Medida} > LSE]}{N} = \frac{1}{20} = 0,05$$
O PPM esperado correspondente a valores fora dos limites de especificação é dado por:
$$(\text{PPM}_\text{esp} > LSE) = 10^6 \times \text{Prob de falha} = 50.000$$
O cálculo do Ppk pode ser expresso por:
$$\text{Ppk} = \frac{\Phi^{-1}(1 - 0,05)}{3} = 0,5483$$