13.3 Estabilidade em uso
Estabilidade em uso
Conforme estabelecido pela RDC nº 318/2019, os estudos de estabilidade em uso são aplicáveis a medicamentos acondicionados em embalagens multidose e têm como objetivo demonstrar que o produto mantém suas características de qualidade durante todo o período de utilização após a primeira abertura da embalagem primária.
Esses estudos fornecem evidências de que o medicamento permanece dentro das especificações estabelecidas mesmo após sucessivas aberturas e fechamentos da embalagem, desde que sejam observadas as condições de armazenamento recomendadas. Os resultados obtidos subsidiam a definição do prazo de utilização após a abertura, assegurando a manutenção da qualidade, segurança e eficácia do produto durante o período de uso.
De acordo com a RDC nº 318/2019, o estudo deve ser conduzido em uma das condições de armazenamento utilizadas para os Estudos de Estabilidade de Longa Duração. O objetivo é verificar se o medicamento mantém comportamento estável durante todo o período em que permanece em uso pelo paciente ou usuário.
Normalmente, a avaliação contempla um resultado inicial, obtido antes ou imediatamente após a primeira abertura da embalagem, e um resultado final, obtido ao término do período de utilização proposto. Dependendo das características do produto, pontos intermediários também podem ser incluídos para melhor caracterização do comportamento da resposta ao longo do tempo.
Metodologia estatística
A análise estatística dos estudos de estabilidade em uso segue os mesmos princípios empregados nos Estudos de Estabilidade de Longa Duração, utilizando modelos de regressão linear e técnicas de análise de covariância (ANCOVA). Entretanto, diferentemente dos estudos convencionais de estabilidade, o fator avaliado nem sempre corresponde aos lotes de fabricação, podendo representar, por exemplo:
- Diferentes frascos ou embalagens;
- Diferentes condições de utilização;
- Diferentes perfis de abertura e fechamento;
- Outros fatores experimentais previstos no protocolo.
Como a metodologia estatística é essencialmente a mesma utilizada para os estudos de longa duração, sua descrição detalhada não será repetida nesta seção. A seguir apresentamos apenas o fluxo decisório utilizado para seleção do modelo estatístico apropriado.
Procedimento para a seleção do Modelo Estatístico
A escolha da avaliação estatística mais adequada depende de como se comporta cada unidade (lote). Existem três cenários possíveis:
- Cenário 1: todas as unidades ou lotes apresentam comportamento semelhante (intercepto e coeficiente angular igual) e um modelo único descreve adequadamente os dados.
- Cenário 2: existem diferenças no valor inicial (intercepto), mas a taxa de alteração ao longo do tempo (coeficiente angular) é semelhante. Deverá ser ajustado um modelo para cada lote com alteração no valor do intercepto.
- Cenário 3: ao menos algum coeficiente angular é diferente, exigindo a consideração da interação tempo × fator.
Definido o tipo de cenário encontrado, o procedimento é o seguinte:
-
Ajusta-se inicialmente um modelo contendo os efeitos de tempo, fator e a interação tempo × fator (Cenário 3).
-
Avalia-se, por meio da ANCOVA, a significância da interação tempo × fator:
- Se p ≤ 0,25, conclui-se que as inclinações são diferentes e utiliza-se o modelo com interação (Cenário 3);
- Se p > 0,25, a interação é removida e ajusta-se o modelo contendo apenas os efeitos principais (Cenário 2).
- No modelo sem interação, avalia-se a significância do fator:
- Se p ≤ 0,25, conclui-se que existem diferenças entre os interceptos e utiliza-se o modelo contendo tempo e fator (Cenário 2);
- Se p > 0,25, o fator é removido e ajusta-se o modelo contendo apenas o efeito do tempo (Cenário 1).
Após a definição do modelo mais adequado, utiliza-se a equação de regressão obtida para avaliar a tendência da resposta ao longo do tempo e verificar sua conformidade com os limites de especificação estabelecidos.
Exemplo
Apresenta-se um exemplo para estudo de estabilidade em uso cuja unidade de tempo está dada em horas. Considere-se para os seguintes dados:
| Fator | Tempo | Resposta |
|---|---|---|
| 1 | 0 | 3,9 |
| 1 | 1 | 3,9 |
| 1 | 2 | 3,4 |
| 1 | 3 | 3,3 |
| 1 | 4 | 3,4 |
| 1 | 5 | 3,6 |
| 1 | 6 | 3,4 |
| 1 | 7 | 3,4 |
| 1 | 8 | 3,5 |
| 2 | 0 | 3,9 |
| 2 | 1 | 3,9 |
| 2 | 2 | 3,7 |
| 2 | 3 | 3,4 |
| 2 | 4 | 3,5 |
| 2 | 5 | 3,5 |
| 2 | 6 | 3,5 |
| 2 | 7 | 3,5 |
| 2 | 8 | 3,4 |
| 3 | 0 | 3,7 |
| 3 | 1 | 3,4 |
| 3 | 2 | 3,8 |
| 3 | 3 | 3,5 |
| 3 | 4 | 3,7 |
| 3 | 5 | 3,4 |
| 3 | 6 | 3,4 |
| 3 | 7 | 3,3 |
| 3 | 8 | 3,1 |
| 4 | 0 | 3,7 |
| 4 | 1 | 3,4 |
| 4 | 2 | 3,4 |
| 4 | 3 | 3,3 |
| 4 | 4 | 2,9 |
| 4 | 5 | 2,9 |
| 4 | 6 | 2,9 |
| 4 | 7 | 2,5 |
| 4 | 8 | 2,5 |
Tabela 13.3.1: Dados para análise de Estabilidade em Uso
Através dos dados acima mostrados, obtém-se a matriz de delineamento (matriz X):
$$
X = \begin{bmatrix}
1 & 0 & 0 & 0 & 0 & 0 & 0 & 0 \
1 & 1 & 0 & 0 & 0 & 0 & 0 & 0 \
1 & 2 & 0 & 0 & 0 & 0 & 0 & 0 \
1 & 3 & 0 & 0 & 0 & 0 & 0 & 0 \
1 & 4 & 0 & 0 & 0 & 0 & 0 & 0 \
1 & 5 & 0 & 0 & 0 & 0 & 0 & 0 \
1 & 6 & 0 & 0 & 0 & 0 & 0 & 0 \
1 & 7 & 0 & 0 & 0 & 0 & 0 & 0 \
1 & 8 & 0 & 0 & 0 & 0 & 0 & 0 \
1 & 0 & 1 & 0 & 0 & 0 & 0 & 0 \
1 & 1 & 1 & 0 & 0 & 1 & 0 & 0 \
1 & 2 & 1 & 0 & 0 & 2 & 0 & 0 \
1 & 3 & 1 & 0 & 0 & 3 & 0 & 0 \
1 & 4 & 1 & 0 & 0 & 4 & 0 & 0 \
1 & 5 & 1 & 0 & 0 & 5 & 0 & 0 \
1 & 6 & 1 & 0 & 0 & 6 & 0 & 0 \
1 & 7 & 1 & 0 & 0 & 7 & 0 & 0 \
1 & 8 & 1 & 0 & 0 & 8 & 0 & 0 \
1 & 0 & 0 & 1 & 0 & 0 & 0 & 0 \
1 & 1 & 0 & 1 & 0 & 0 & 1 & 0 \
1 & 2 & 0 & 1 & 0 & 0 & 2 & 0 \
1 & 3 & 0 & 1 & 0 & 0 & 3 & 0 \
1 & 4 & 0 & 1 & 0 & 0 & 4 & 0 \
1 & 5 & 0 & 1 & 0 & 0 & 5 & 0 \
1 & 6 & 0 & 1 & 0 & 0 & 6 & 0 \
1 & 7 & 0 & 1 & 0 & 0 & 7 & 0 \
1 & 8 & 0 & 1 & 0 & 0 & 8 & 0 \
1 & 0 & 0 & 0 & 1 & 0 & 0 & 0 \
1 & 1 & 0 & 0 & 1 & 0 & 0 & 1 \
1 & 2 & 0 & 0 & 1 & 0 & 0 & 2 \
1 & 3 & 0 & 0 & 1 & 0 & 0 & 3 \
1 & 4 & 0 & 0 & 1 & 0 & 0 & 4 \
1 & 5 & 0 & 0 & 1 & 0 & 0 & 5 \
1 & 6 & 0 & 0 & 1 & 0 & 0 & 6 \
1 & 7 & 0 & 0 & 1 & 0 & 0 & 7 \
1 & 8 & 0 & 0 & 1 & 0 & 0 & 8 \
\end{bmatrix}
$$
Estima-se o vetor de parâmetros $\beta$ e encontra-se o modelo ANCOVA por:
$$\widehat{\beta} = \left(X^\top X\right)^{-1}X^\top Y = \begin{bmatrix} \widehat{\beta}_0 \ \widehat{\beta}_1 \ \widehat{\beta}_2 \ \widehat{\beta}_3 \ \widehat{\beta}_4 \ \widehat{\beta}_5 \ \widehat{\beta}_6 \ \widehat{\beta}_7 \end{bmatrix}$$
Sabe-se que a soma de quadrados do erro $(SQE)$ satisfaz:
$$\dfrac{SQE}{\sigma^2}\sim\chi^{2}_{n-2K}.$$
Portanto, um estimador não viciado para $\sigma^2$ é dado por:
$$\widehat{\sigma}^2=QME=\dfrac{SQE}{n-2K}.$$
$$SQE=Y^t \times \left( I - X\times (X^t\times X)^{-1}\times X^t \right)\times Y=0,636.$$
e a estimativa da variabilidade é dada por
$$\widehat{\sigma}^2=QME=\dfrac{SQE}{n-2K}=\frac{0,636}{36-8}=0,0227.$$
Na sequência analisa-se as hipóteses de paralelismo. Por meio do teste F parcial avalia-se as seguintes hipóteses:
$$
\begin{cases}
H_{0}: \beta_5 = \beta_6 = \beta_7 = 0 \
H_{1}: \text{pelo menos um }\beta_i \neq 0 \text{ para i = 5, 6 e 7}
\end{cases}
$$
Calculando a soma de quadrados da regressão do modelo reduzido tem-se:
$$SQR\left(\beta_{R2}\right) = \widehat{\beta}_{R2}^\top X_{R2}^\top Y - \dfrac{Y^{\top}JY}{n} =3,0691$$
Então, a soma de quadrados referente aos parâmetros da hipótese nula é dada por:
$$SQR\left(\beta|\beta_{R2}\right) = SQR\left(\beta\right) - SQR\left(\beta_{R2}\right) = 3,4674 - 3,0691 = 0,3983$$
Desta forma, pode-se calcular a estatística do teste F por:
$$F_P = \dfrac{\dfrac{SQR\left(\beta|\beta_{R2}\right)}{K-1}}{QME} = \dfrac{\dfrac{0,3983}{3}}{0,0227} = 5,8487$$
Em que $F_P$ possui distribuição $F$ com $K-1$ e $N-2K$ graus de liberdade. Calcula-se o p-valor do teste por:
$$p-valor = \mathbb{P}\left(F_{(3, 28)} > 5,8487 )\right) = 0,0031$$
No teste de Paralelismo tem-se evidência para rejeitar a hipótese nula ao nível de significância de 0,25 e concluí-se que deve-se ajustar diferentes coeficientes angulares para os lotes.
Desse modo, como houve a rejeição da hipótese nula do teste de paralelismo, ajusta-se um modelo contendo o tempo, o fator lote e a interação entre eles.
O próximo passo é estimar o modelo de regressão para o estudo. Como rejeitou-se o paralelismo tem-se que cada lote irá possuir um coeficiente angular diferente dos outros.
$$\widehat{\beta} = \left(X^\top X\right)^{-1}X^\top Y$$
$$ \hat{\beta}=\left[ 3,7200 ; -0,0467 ; 0,1022 ; -0,0022 ; -0,0711 ; -0,0117 ; -0,0133 ; -0,1017 \right]^\top $$
Portanto, o modelo completo é dado por:
$$ Y_i = \beta_0 + \beta_1Tempo_i+\beta_2Lote2_i+\beta_3Lote3_i+ \beta_4Lote4_i + \ \beta_5Lote2_i * Tempo_i+\beta_6Lote3_i * Tempo_i+ \beta_7*Lote4_i * Tempo_i + \epsilon_i, $$
$$
\widehat{Y}_i = 3,7200 + -0,0467Tempo_i+0,1022Lote2_i -0,0022Lote3_i -0,0711Lote4_i \
-0,0117Lote2_i * Tempo_i - 0,0133Lote3_iTempo_i - 0,1017Lote4_i * Tempo_i
$$
tal que $Y_i$ representa a resposta estimada para $i=1,…,n$ e $n=36$ o total de dados.
Desta forma, pode-se separar o modelo por fator:
Fator 1
$$Y_i = 3,72000 -0,04667*Tempo$$
Note que a base para o cálculo do Intercepto é utilizando o fator $ 1 $
Fator 2
$$Y_i = (3,72000 + 0,1022) + (-0,0467 -0,0117)*Tempo$$
$$Y_i = 3,82222 - 0,05833*Tempo$$
Fator 3
$$Y_i = (3,72000 - 0,0022) + (-0,0467 - 0,0133)*Tempo$$
$$Y_i = 3,71778 - 0,06000*Tempo$$
Fator 4
$$Y_i = (3,72000 - 0,0711) + (-0,0467 - 0,1017)*Tempo$$
$$Y_i = 3,64889 - 0,14833*Tempo$$
Observe que tem-se apenas um modelo geral para o estudo, nesses modelos separados por fator ocorre apenas a atribuição de valores (0 ou 1) às covariáveis dependendo do fator de interesse.
Seguem as saídas do Action Stat:
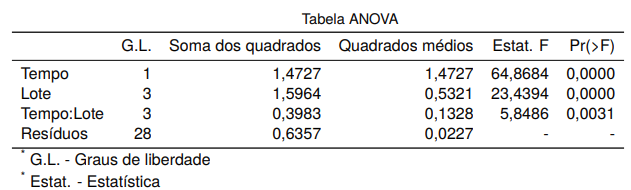
Figura 13.3.1: Tabela da ANOVA
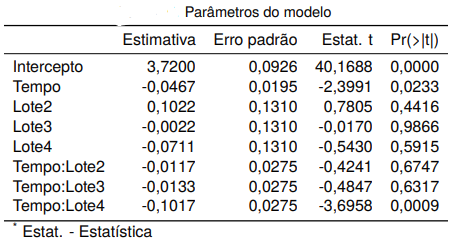
Figura 13.3.1: Coeficientes do modelo
Em seguida, fixa-se o limite inferior de aceitação em 2,5% e o limite superior em 4,1%. É necessário realizar previsões da resposta média por fator para os próximos 10 horas com um intervalo de confiança de 95%. Tem-se, nesse caso, o cenário 3, isto é, um intercepto para cada lote e um coeficiente angular também para cada lote, então o intervalo de confiança é dado por:
$$IC\left(\mu_{Y|x}^i, 100(1-\alpha)%\right) = \left[ x_i^T \widehat{\beta} \pm t_{(n-p-1)} \widehat{\sigma} \sqrt{x_i^\top\left(X^\top X\right)^{-1}x_i}\right]$$
Para o exemplo, será calculado os limites do intervalo de confiança do tempo (horas) $ t = 6 $ e o fator $4$, para o cálculo tem-se os seguinte valores:
$$ x_{10}=\left[1,6,0,0,1,0,0,6\right]^T $$
$$\hat{\beta}=\left[ 3,7200 ; -0,0467 ; 0,1022 ; -0,0022 ; -0,0711 ; -0,0117 ; -0,0133 ; -0,1017 \right]^T $$
Então,
$$\hat{y}{6} = x{6}^{T}\hat{\beta} = 2,7589 $$
$$\hat{\sigma} = \sqrt{\hat{\sigma^2}} =\sqrt{QME} = \sqrt{\dfrac{SQE}{36-7-1}} = \sqrt{\dfrac{Y^t \times \left( I - X\times (X^t\times X)^{-1}\times X^t \right)\times Y}{28}} = \sqrt{\dfrac{0,63567}{28}} = 0,15067$$
$$t_{(1-\alpha/2; 36-7-1)} = t_{(0,975; 28)} = 2,0484 $$
$$\sqrt{x_{6}^T(X^TX)^{-1}x_{6}} = 0,4216 $$
Finalmente,
$$IC_{Inf}({y_{6}},95%)= 2,7589 - 0,15067 * 2,0484 * 0,4216 = 2,6288$$
$$IC_{Sup}({y_{6}},95%)= 2,7589 + 0,15067 * 2,0484 * 0,4216 = 2,8890$$
Tem-se que $ IC_{Inf}({y_{6}},95%) = 2,6288 > 2,5 $ e $ IC_{Sup}({y_{6}},95%) = 2,8890 < 4,1 $, portanto ainda não encontra-se a data de expiração.
Continuando os cálculos para o fator 4 para 7 horas, obtém-se $ IC_{Inf}({y_{6}},95%) = 2,4528 < 2,5 $ enquanto para outros fatores não foi identificado um limite inferior de degradação abaixo de 2,5% ou um limite superior acima de 4,1% durante as 10 horas. Nessa situação, considera-se o tempo de expiração detectado igual a 6 horas.
Seguem as saídas do Action Stat:
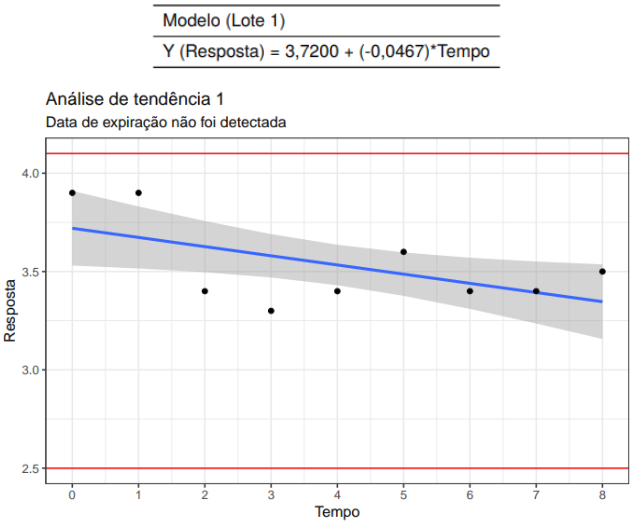
Figura 13.3.3: Modelo para o lote 1
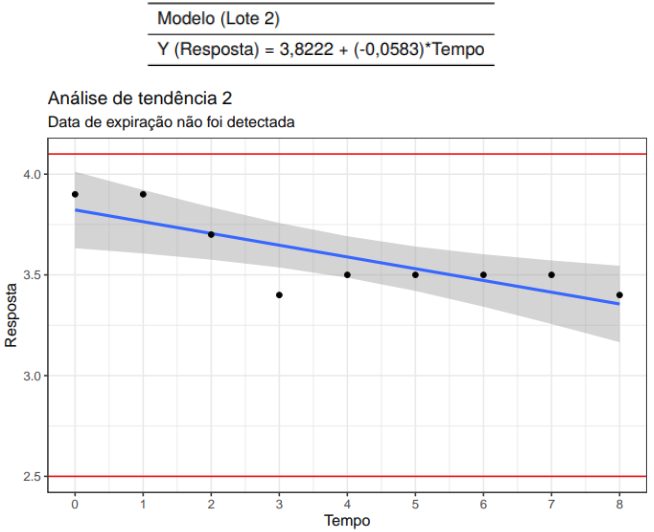
Figura 13.3.4: Modelo para o lote 2
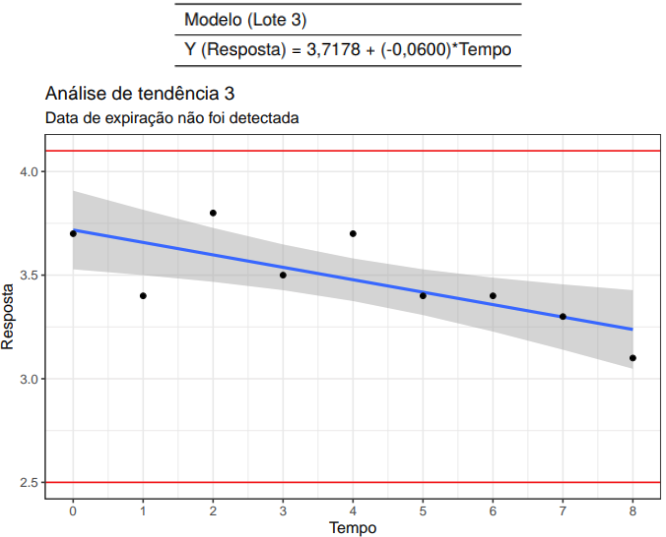
Figura 13.3.5: Modelo para o lote 3
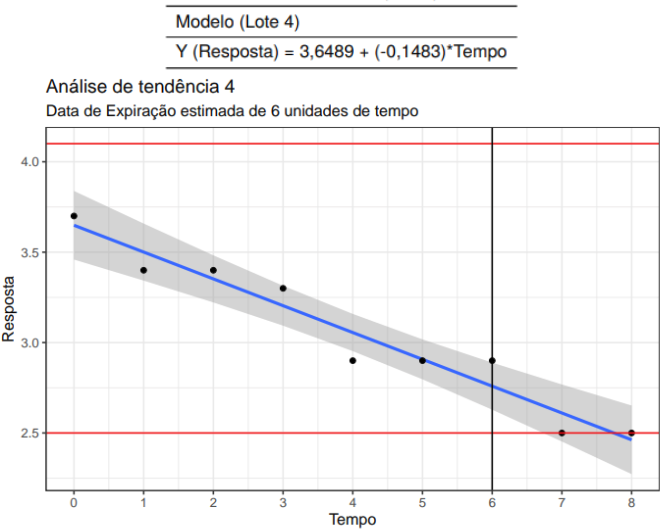
Figura 13.3.6: Modelo para o lote 4
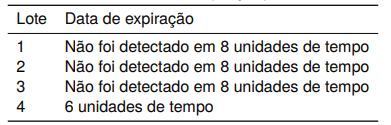
Figura 13.3.7: Data de expiração
O gráfico abaixo mostra um comparativo do comportamento de tendência de todos os lotes. Observa-se que o lote 4 apresenta uma tendência de queda maior que os demais.
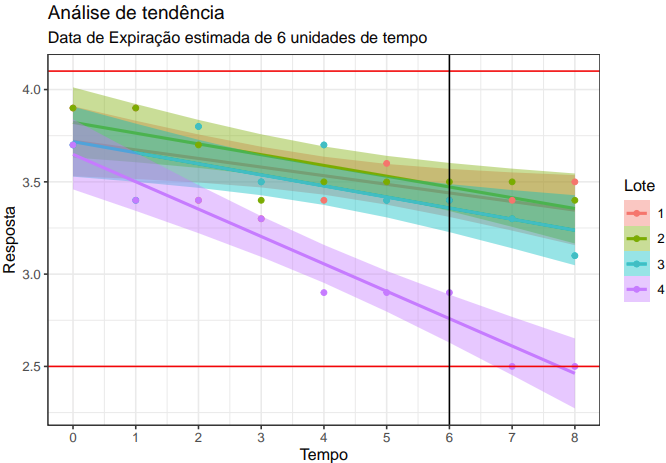
Figura 13.3.8: Tendência de cada lote
Os cálculos das especificações de liberação são baseados na significância do coeficiente angular (tendência) e no intervalo de confiança para o prazo de validade obtido.
A seguir apresentam-se as especificações de liberação obtidas para o tempo de 6 horas. Como a interação entre o Tempo e o Lote é significativa, retira-se a tendência da especificação. O coeficiente angular utilizado para o cálculo da tendência é o de maior magnitude em módulo, que para este estudo corresponde a -0,1483 (Lote 4).
As expressões utilizadas para calcular as especificações de liberação são as seguintes:
- LIL = LIE + |Tendência| + Banda Confiança
- LSL = LSE - Banda Confiança
As especificações calculadas são dadas na tabela abaixo:
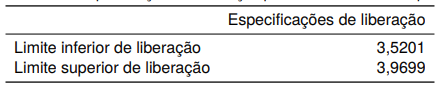
Figura 13.3.9: Especificações de Liberação
O gráfico de resíduos padronizados mostra que não há presença de valores fora de tendência (outliers).
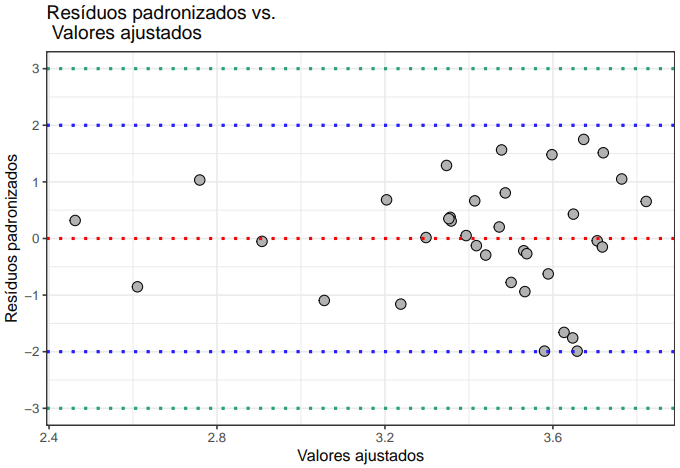
Figura 13.3.10: Avaliação de outliers